

作者:Alastair Waite, 康普全球数据中心市场开发高级经理
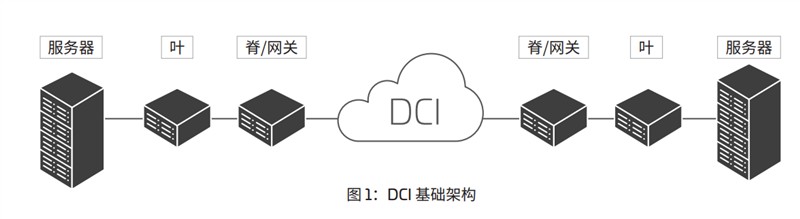
本文中,我们将数据中心互连 (DCI) 定义为连接两个或多个独立数据中心的物理基础设施,以此展开 DCI 用例和传输方法的探讨。DCI 的地理覆盖范围差异很大,可能包含互联园区内的多个数据中心;不过,DCI 更常用于描述跨越多个城市的数据中心集群(也称为“可用区”)。从更大的层面来看,遍布全球的数据中心网络相互连接,形成全球数据中心互连 (DCI)。
数据中心互连及跨域扩展对 AI 的重要意义
为什么 DCI 已成为当今数据中心领域的重要话题?DCI 早已存在且一直至关重要;然而,AI 应用最近带来了重大变化,使 DCI 成为影响大语言模型 (LLM) 训练整体性能和经济效益的关键因素,而这一变革的核心正是规模化扩展。
简单来说,纵向扩容网络用于将单个机柜中的大量 GPU 相互连接,形成一个单一的计算块。当机柜的供电、空间或散热能力达到上限,无法容纳更多 GPU 时,同一数据中心或机房内的相邻机柜会连接到一起,形成横向扩展网络。横向扩展网络会使算力大幅提升,同时维持 GPU 运行所需的电力消耗也显著增加。供电能力是限制单个数据中心建筑内可容纳基础设施数量的常见制约因素。为此,需要建设新的数据中心,无论是在园区内、城市内还是区域内,以容纳训练大型及超大规模模型所需的额外算力资源。
对于需要分布式算力的超大模型,必须让地理上分散的数据中心协同工作,而 DCI 在此发挥着关键作用。事实上,DCI 变得如此重要,以至于出现了一个新术语来描述 DCI 网络:跨域扩展。用于训练超大 LLM 的数据中心通常不再是孤立的孤岛,而是成为建筑群的一部分,形成高度互联的跨域结构,通过横向扩展,无缝地满足日益增加的东西向流量需求。这种跨域网络统称为面向 AI 优化的 DCI。
据 Dell'Oro Group 预测,2025 年至 2028 年间,直接 DCI 的年度采购容量预计将增长三倍,其中大部分接口将采用 800G、1.2T 或 1.6T 相干光、ZR 和 ZR+ 收发器标准。
新的 DCI 流量类型
受 AI 需求驱动,DCI 流量类型变得极为丰富。例如,如今的 DCI 网络可用于传输:
- AI 模型参数(例如,全归约、全互联)
- AI 梯度
- GPU 与 GPU 和节点与节点之间的同步数据
- 对时延敏感的大型数据流
- 用于故障检测、调度、网络遥测、故障检测和恢复信号的控制和编排数据。
需要理解的是,这类数据大部分是用于保持网络架构与分布式任务同步的中间计算数据,而非图像、文档等用户数据。尽管这些 DCI 流量模式主要由模型训练活动驱动,但根据所部署的架构模型,推理 AI 也可能需要通过 DCI 传输大量数据来同步操作。目前,AI 训练(而非推理)是流量增长的最大驱动因素;然而,随着行业从以训练为主转向部署更多基础设施来支持推理,这种情况预计未来会发生变化。
AI 带来多数据中心 DCI 挑战
大型 AI 模型拥有 700 亿个或更多参数,而 ChatGPT 4 等超大模型的参数更是超过一万亿个,因此在跨多个数据中心管理算力时,会面临一些关键基础设施挑战。例如,区域间时延会很高(正如 NVIDIA 在这篇技术博客中所解释的,往往达到 20 毫秒或更长),这可能会在大规模 LLM 训练期间形成性能瓶颈。
考虑到这一点及其他许多因素,DCI 网络基础设施的设计必须具备足够的光纤容量,以支持低时延和高带宽通道,确保数据中心之间实现快速、不受限制的通信流,从而最大限度地提高训练效率。
DCI 传输
通过 DCI 在数据中心之间传输数据有多种方式。DCI 技术可能涉及通过专用光纤或波长服务,以光信号形式传输高速以太网信号。在大多数情况下,DCI 需要高速广域网链路,因而可能会用到 MPLS、以太网、VPLS、城域以太网等。
选择合适的 DCI 基础设施、架构和拓扑需考虑多种变量,包括数据中心的位置、数据中心之间的距离、波长和可用性要求、当地服务提供商的实力以及安全问题。深入到组件级别时,也面临着许多选项和变量。以下列举了一些解决方案和发展趋势,可供选型决策参考。
边界边缘(网关)设备
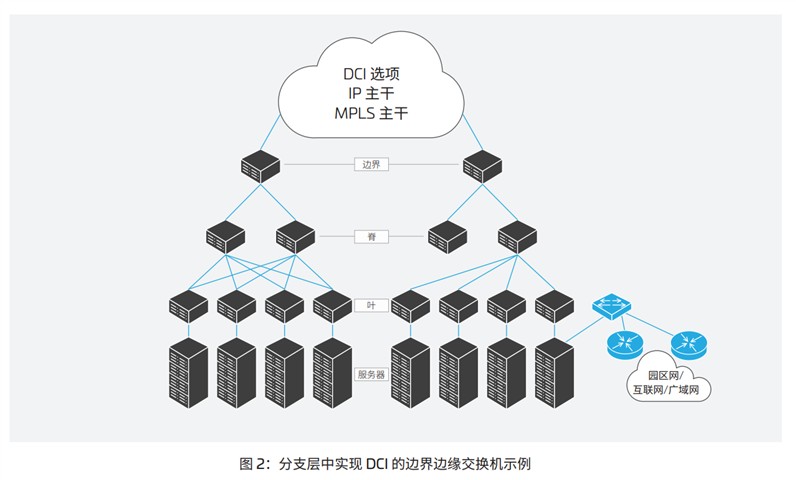
在创建数据中心结构时,叶脊交换机是不可或缺的一部分,可确保高效传输东西向数据。随着数据中心接近云级,脊层交换机通常专用于处理东西向数据流动。架构中添加了一组新的交换机,称为“边界边缘交换机”,用于处理数据中心结构边缘的传入和传出流量。在某些情况下,可以使用边界叶交换机在叶层执行将数据移交给 DCI 网络的工作。
相干光学元件
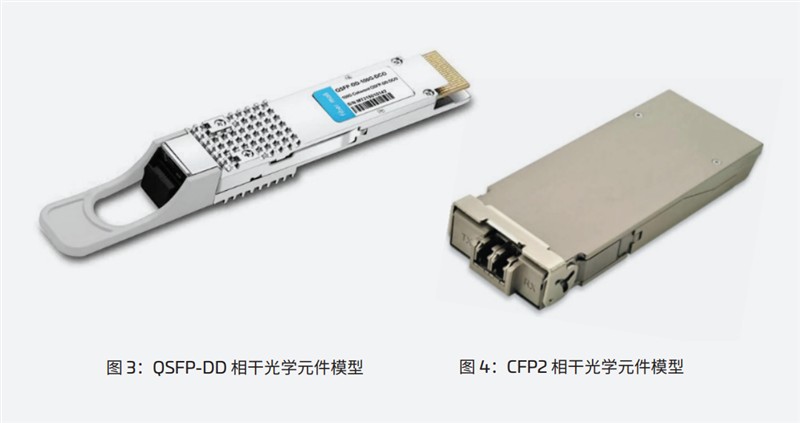
相干传输在长距离和海底链路中已有大约十年的使用历史,而这项技术现正迁移到数据中心。随着时间推移,相干收发器的制造商已减少了其光学元件的尺寸、功率和成本,以便更易于用到越来越短的链路中。IEEE 以太网对在高达 80 千米的光纤链路上采用 100G 和 400G 相干信号进行了标准化。新项目 (802.3dj) 将为在仅 10 千米上采用 800G 相干技术编写标准。光互联论坛 (OIF) 已发布 400ZR 和 800ZR 标准,规定了在单波长下传输距离为 80-120 公里的 800G 信号。OIF 目前正在开展 1600ZR 标准的制定工作。
随着数据中心不断发展壮大,互联程度也越来越高,DCI 网络的带宽需求也在不断增长,在多个波长上可达 100T。这种带宽需求由更快的数据传输速率(每个波长 400G 和 800G)来支持,并且这种需求只会继续增长。
相干光学元件通常用于超高带宽应用,可在极长距离范围内实现从 100G 到 1T 的传输。这些系统中内嵌了强大的数字信号处理芯片 (DSP),可缓解光纤损伤造成的线性效应,包括色散和偏振模色散。
相干光纤元件利用光的自然属性,优化数字调制方式及其在远距离应用中的承载性能。但是,相干传输将发生变化以适应 DCI 应用。在拟议的新标准 (IEEE802.3dj) 的支持下,有望在 10 千米的距离内实现 800G 链路。
密集波分复用 (DWDM)
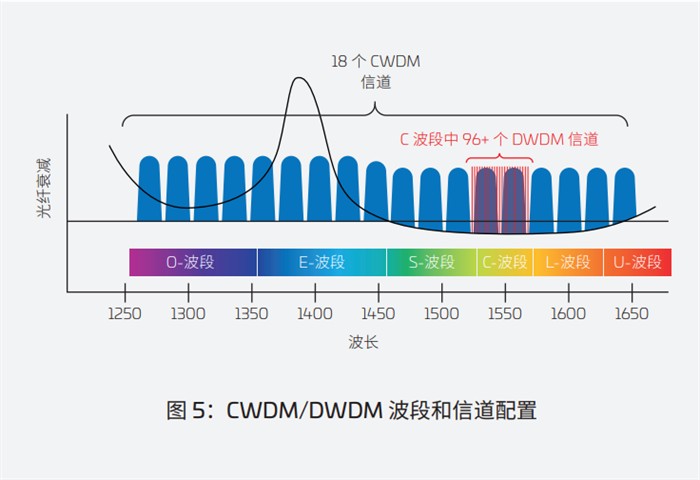
DWDM 使多个波长的光可以同时穿过同一光纤,每个波长承载一个独立的信号。紧密的波长间距可在单根光纤上实现 96 个信道。DWDM 是一种多功能传输技术,能够支持相干光和开关键控 (OOK) 幅度信号传输。与相干调制结合使用时,单个信道带宽可扩展到 400G 或 800G(见图 5)。
QPSK 相干编码与 PAM4 的比较
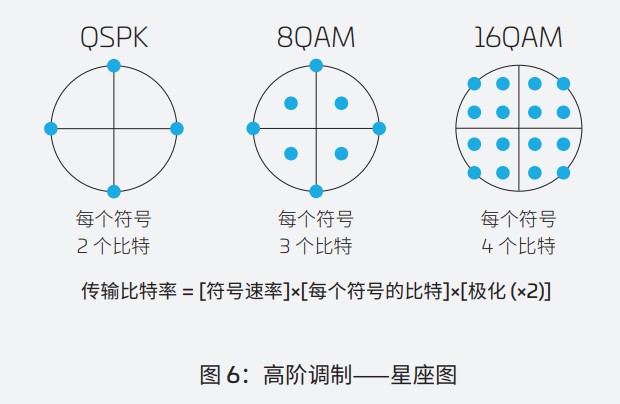
相干系统以相移键控 (PSK) 技术为基础,这是一种相位调制技术,支持根据四个相移方向(例如 0°、90°、180° 和 270°)对每个比特的多个符号进行编码。许多系统使用正交相移键控 (QPSK) 来编码每个符号的 2 个比特。双极化 QPSK (DP QPSK) 使用水平和垂直极化以及 QPSK 代表两倍的比特(见图 6)。
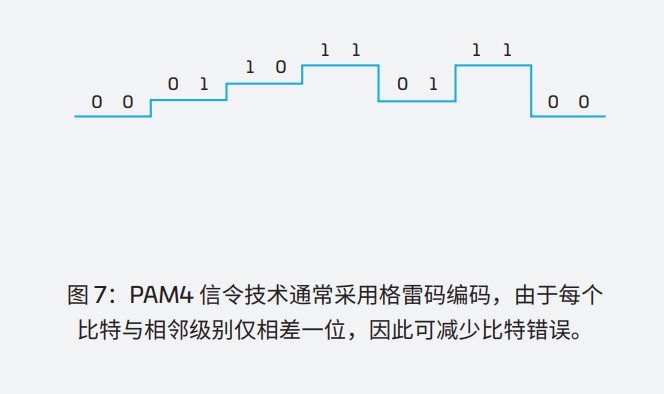
脉幅调制 (PAM) 是一种调制方案,而四电平脉幅 (PAM4) 是其中的四电平调幅方法,专为短程光纤链路设计。PAM4(见图 7)使用四个振幅脉冲,每个脉冲包含两个比特的数据,可使传统二进制信号的带宽翻倍。四电平脉幅 (PAM4) 兼备简单和低功率的优点,也因此成为了 100G 和 400G 以太网应用的热门选择。
与相干光学元件不同,PAM4 对光纤受损非常敏感。因此其传输范围受到限制,通常不超过 10 千米,而相干光纤通信系统在经过放大的链路上横跨数千千米的距离。
新设计推动包含更多光纤的 DCI 网络
东西向数据流的扩展,加上向低时延叶-脊交换架构的转变,在数据中心内部和数据中心之间造成了数据激增,其是以大模型训练为核心的智算中心。同时使得具有多座楼宇的数据中心园区飞速发展。这种趋势并非仅限于美国的少数几家超大规模数据中心;全球云服务和多租户数据中心 (MTDC) 提供商也会受到影响。
物理层
外部线缆在数据中心内完成端接后,必须熔接到后续目的地,或者连接到跳线和交叉连接设备。此过程使用位于汇接机房 (MMR) 或主配线区 (MDA) 的光纤配线架 (ODF) 来完成,其中所有网络布线汇聚一处,为配线做好准备。
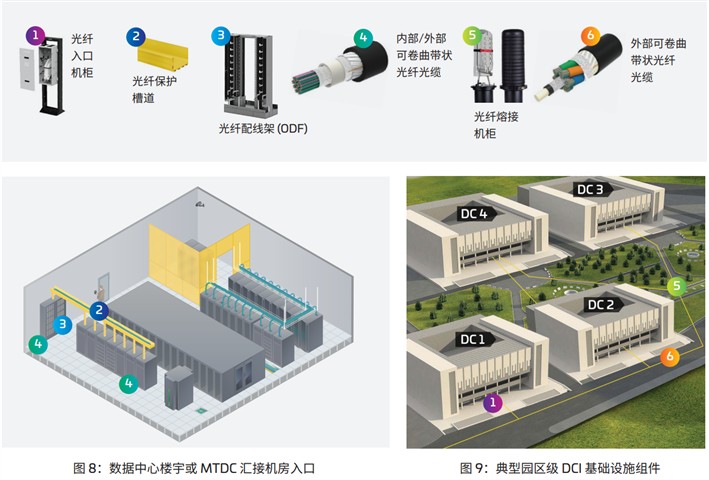
为了确保此区域可以满足未来增长需求并易于管理,跳线必须保持良好的卫生状况。如前所述,DCI 网络正在整个园区中发挥越来越重要的作用,并将在不久的将来为 100T 或以上的吞吐量提供支持。这将需要数千根光纤,这些光纤将全部汇集在 MMR 或 MDA 中,因此跳线管理至关重要。所以必须要确保同时对 ODF 进行光纤跳线布线管理和光纤松弛管理,这将是确保 MDA 和 MMR 可满足所有未来需求的关键。
面向未来
未来,DCI 网络的部署和扩展将持续推进,覆盖更广泛的园区并深入云端,这一发展趋势无可阻挡。随着 AI 对网络扩容的需求不断增长,不间断运行的 GPU 会创建和共享越来越多的数据。相应地,数据负载和跨域 DCI 网络的需求也会持续攀升。这为园区网络设计人员带来了实际挑战,尤其是必须跨城域或在第三方拥有的土地上互连数据中心时。如果数据要无缝且顺畅地遍历这些地理位置,光缆的数据承载能力必须有所提升。这可以通过两种方式实现:一是通过在每根光缆中添加更多光纤(通过减小包层尺寸),二是引入商业上可行的替代光纤技术,例如空芯光纤。但无论采用何种方式,DCI 在智算中心的增长和发展中将变得越来越重要。
参与评论 (0)